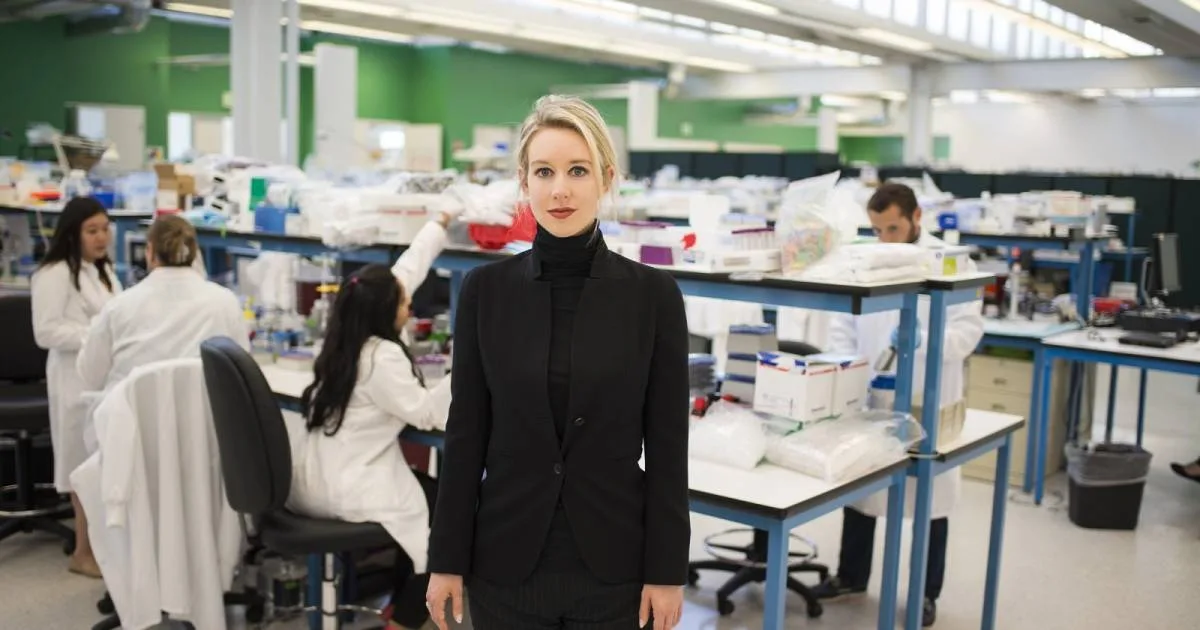
O caso Elizabeth Holmes não é apenas uma história sobre uma startup que prometeu demais. Para quem desenvolve software ou produtos com inteligência artificial, ele expõe um risco mais profundo: confundir uma demonstração convincente com um sistema validado. Segundo o Abril.com.br, o documentário Tudo Pode Ser Visto acompanha os últimos 34 dias de liberdade da ex-fundadora da Theranos. A história da empresa, porém, também merece atenção como estudo de engenharia, governança e comunicação de risco.
Holmes abandonou Stanford para fundar a Theranos, que prometia realizar exames complexos usando uma pequena quantidade de sangue. A ideia era atraente: menos coleta, mais conveniência e resultados rápidos. O problema foi a distância entre a promessa pública e o que a tecnologia conseguia entregar de forma confiável. Quando um produto afeta decisões médicas, essa diferença não é um detalhe de marketing. É uma questão de segurança.
O caso Theranos e a diferença entre uma demo e um produto confiável
Uma demonstração pode funcionar em condições controladas. Um produto precisa continuar funcionando quando mudam o usuário, o ambiente, a qualidade dos dados e as condições de operação. Essa diferença é familiar para quem já apresentou um protótipo que funcionava com um conjunto pequeno de dados, mas ainda não estava pronto para produção.
No diagnóstico laboratorial, o resultado não depende apenas do equipamento. Também entram na conta a coleta, o transporte e o armazenamento da amostra, os reagentes, a calibração, os controles de qualidade e a interpretação do resultado. Uma amostra capilar, obtida por punção na ponta do dedo, não é automaticamente equivalente a uma amostra venosa. Volume reduzido, hemólise e variação na composição podem influenciar a medição.
Isso não significa que tecnologias de coleta pequena sejam impossíveis. Significa que cada exame precisa demonstrar desempenho adequado para o uso proposto. A pergunta correta não é “a máquina conseguiu produzir um número?”, mas “o resultado é preciso, reprodutível e seguro o suficiente para apoiar uma decisão clínica?”.
Validação de software médico: métricas, dados e limites de uso
Na prática, equipes de software costumam tratar testes como uma etapa final: implementam o recurso, verificam se o código roda e corrigem bugs visíveis. Em sistemas que afetam saúde, isso é insuficiente. A validação precisa começar pela finalidade do produto e pelos riscos de uma decisão incorreta.
Se um modelo classifica exames, por exemplo, a acurácia isolada pode esconder falhas importantes. Um conjunto com muitos casos negativos pode apresentar acurácia alta mesmo que o sistema deixe passar uma parcela preocupante dos casos positivos. Sensibilidade e especificidade ajudam a enxergar melhor esse comportamento, mas também não substituem avaliação clínica, análise de subgrupos ou revisão independente.
Este exemplo calcula duas métricas básicas a partir de rótulos reais e previsões. É útil para entender o fluxo, não para certificar um dispositivo médico. Em um projeto real, eu também avaliaria intervalos de confiança, qualidade da referência diagnóstica, viés de seleção e desempenho em dados externos.
def calcular_metricas(rotulos_reais, previsoes):
    if len(rotulos_reais) != len(previsoes):
        raise ValueError("As listas precisam ter o mesmo tamanho.")
    if not rotulos_reais:
        raise ValueError("É necessário informar pelo menos um caso.")

    tp = sum(r == 1 and p == 1 for r, p in zip(rotulos_reais, previsoes))
    tn = sum(r == 0 and p == 0 for r, p in zip(rotulos_reais, previsoes))
    fp = sum(r == 0 and p == 1 for r, p in zip(rotulos_reais, previsoes))
    fn = sum(r == 1 and p == 0 for r, p in zip(rotulos_reais, previsoes))

    sensibilidade = tp / (tp + fn) if tp + fn else None
    especificidade = tn / (tn + fp) if tn + fp else None

    return {
        "sensibilidade": sensibilidade,
        "especificidade": especificidade,
        "verdadeiros_positivos": tp,
        "falsos_negativos": fn,
        "falsos_positivos": fp,
        "verdadeiros_negativos": tn,
    }


reais =      [1, 1, 0, 0, 1, 0]
previstos =  [1, 0, 0, 1, 1, 0]

print(calcular_metricas(reais, previstos))
O código é simples de propósito. Ele deixa explícito que falsos positivos e falsos negativos têm consequências diferentes. Em uma aplicação clínica, a decisão sobre qual erro tolerar não deve ser tomada apenas por quem implementa o modelo: depende do uso, do contexto médico e de evidências apropriadas.
Por que a história interessa a desenvolvedores de IA
O caso também ajuda a separar três coisas que muitas vezes aparecem misturadas: uma hipótese técnica, um protótipo e uma solução comprovada. Um protótipo mostra que uma abordagem pode funcionar em algum cenário. Um produto confiável precisa mostrar em quais cenários funciona, onde falha e como essas falhas são detectadas.
Em inteligência artificial, é fácil transformar uma boa demonstração em uma narrativa de capacidade geral. Um modelo pode acertar exemplos selecionados e falhar quando recebe dados de outra população, de outro dispositivo ou de outro período. Mudanças de distribuição, vazamento de dados e métricas escolhidas depois de olhar os resultados podem criar uma impressão de desempenho que não se sustenta fora do laboratório.
Também há uma diferença entre transparência técnica e transparência de marketing. Dizer que um modelo usa uma arquitetura avançada não responde às perguntas centrais: qual tarefa ele realiza, com quais dados foi avaliado, quais grupos foram representados e o que acontece quando a confiança é baixa? Documentação, registros de versão e limitações conhecidas não são burocracia acessória. São parte do produto.
Na Prática: como avaliar uma promessa tecnológica antes de lançá-la
- Defina a afirmação em termos testáveis. Troque “o sistema revoluciona exames” por uma descrição verificável: quais exames, para quais amostras, em que condições e com qual desempenho esperado.
- Separe desenvolvimento e avaliação. Não use os mesmos dados para ajustar o sistema e declarar que ele funciona. Reserve dados de teste e, quando possível, avalie em uma instituição ou população externa.
- Escolha métricas ligadas ao risco. Acurácia pode ser insuficiente. Determine quais erros são mais danosos e acompanhe as métricas relevantes para cada decisão.
- Registre falhas e mudanças. Mantenha versões do modelo, parâmetros, dados de avaliação e incidentes. Sem essa trilha, fica difícil reproduzir resultados ou descobrir quando uma atualização degradou o produto.
- Defina limites e supervisão. Se o sistema não foi validado para determinado uso, essa restrição precisa aparecer na documentação e na interface, não apenas em uma apresentação interna.
Esse processo não transforma automaticamente uma aplicação em produto médico seguro. Ele cria uma base melhor para revisão por especialistas, avaliação regulatória e decisões de lançamento. Nos Estados Unidos, por exemplo, regras como as associadas à FDA e à CLIA entram em contextos diferentes; a classificação depende do produto e do uso pretendido. Equipes que atuam em outros países precisam considerar as normas locais, em vez de presumir que uma regra estrangeira resolve tudo.
Alternativas reais: quando não reinventar o fluxo inteiro
Uma promessa de diagnóstico no ponto de atendimento pode ser útil, mas não é a única forma de reduzir atrito. Laboratórios convencionais usam processos estabelecidos para coleta e processamento de amostras. Equipamentos de diagnóstico próximo ao paciente podem atender necessidades específicas, desde que tenham validação compatível com o uso. Em muitos casos, uma melhoria de software — agendamento, rastreabilidade, comunicação de resultados ou integração com sistemas clínicos — resolve parte do problema sem substituir toda a infraestrutura laboratorial.
Para quem constrói produtos, a lição é comparar a solução com alternativas operacionais reais, não apenas com o cenário ideal. Uma nova tecnologia pode ser mais rápida em uma etapa e introduzir custo, variabilidade ou manutenção em outra. A análise precisa considerar o fluxo completo: coleta, processamento, controle de qualidade, interpretação, suporte e resposta a resultados inconclusivos.
Erros comuns ao desenvolver tecnologia de alto impacto
- Confundir protótipo com evidência. Uma demo demonstra uma possibilidade; não comprova desempenho consistente em condições reais.
- Otimizar a métrica errada. Uma métrica agregada pode esconder falhas em grupos menores ou em casos de maior risco.
- Tratar revisão como obstáculo. Em saúde, segurança e finanças, revisão independente pode revelar problemas que a equipe próxima ao projeto deixou de perceber.
- Esconder incerteza na interface. Um resultado apresentado com falsa precisão incentiva decisões excessivamente confiantes. A interface deve comunicar limites e orientar o próximo passo.
- Deixar a narrativa correr à frente do produto. Marketing, captação e pressão por crescimento não substituem testes, documentação e prestação de contas.
Na minha leitura, a parte mais útil do caso para quem programa não é a ideia simplista de que “tecnologia pode dar errado”. Todo software pode falhar. O alerta mais concreto é que incentivos e hierarquia podem dificultar que alguém diga “a evidência ainda não sustenta essa promessa”. Uma equipe saudável precisa tornar essa frase possível — e criar processos para que ela seja investigada, não punida.
FAQ: perguntas de desenvolvedores sobre o caso Theranos
O que a Theranos prometia fazer?
A empresa prometia realizar exames usando pequenas quantidades de sangue, com a proposta de tornar os testes mais simples e acessíveis. A controvérsia envolveu a distância entre essa promessa e a capacidade comprovada da tecnologia.
Por que uma pequena amostra de sangue pode ser um desafio técnico?
O volume e o tipo de amostra podem afetar a preparação e a medição. Fatores como hemólise, concentração dos componentes e variações na coleta precisam ser avaliados para cada exame; não basta obter uma leitura do equipamento.
Qual métrica devo usar para avaliar um modelo de diagnóstico?
Não existe uma métrica única para todos os casos. Sensibilidade, especificidade, valores preditivos e análise por subgrupo podem ser relevantes, mas a escolha depende da finalidade clínica e dos riscos de cada tipo de erro.
Uma validação interna é suficiente para lançar um sistema de IA?
Em geral, não. A equipe deve evitar avaliar o modelo apenas nos dados usados para desenvolvê-lo. Testes independentes e externos ajudam a identificar problemas de generalização, mas não substituem revisão clínica, regulatória e de segurança.
O que o caso ensina a uma equipe de software?
Que alegações precisam ser verificáveis, limitações devem ser documentadas e evidências precisam acompanhar o produto. Em sistemas de alto impacto, a capacidade de interromper um lançamento diante de resultados insuficientes é parte da engenharia responsável.
O documentário citado pelo Abril.com.br transforma a queda de Holmes em uma narrativa sobre manipulação e verdade. Para quem trabalha com tecnologia, a pergunta prática é menos cinematográfica: que evidência eu exigiria antes de colocar uma promessa dessas nas mãos de usuários?
Gostou? Me segue no GitHub e deixa um comentário se tiver dúvida ou quiser aprofundar algum ponto.